Mientras construyo Vertical, he estado pensando mucho en el futuro de la IA. Singularidad, pesos abiertos, inteligencia de frontera. En este artículo, de hecho, argumento que el Dilema del Innovador pronto comenzará a aplicarse a los modelos actuales. Pronto nos importará mucho más el precio y la velocidad que la inteligencia pura.
Cuando pienso en la IA, hay dos flujos de trabajo que son importantes para mí. Productividad y aplicación. Por productividad, me refiero a toda la IA que uso para mí y para gestionar Vertical. En este momento, mi productividad está fuertemente subsidiada por OpenAI y Anthropic, por lo que estos son los modelos principales que utilizo. Por aplicación, me refiero a los modelos que realmente uso para proporcionar Vertical como producto.
Elegir un modelo en la capa de aplicación es mucho más difícil que elegir en la capa de productividad. El coste y la latencia son mucho más importantes aquí (desafortunadamente, OpenAI y Anthropic no me subsidian, y estoy autofinanciado, así que tampoco hay subsidios de capital de riesgo). Hay tres factores:
- Rendimiento del modelo: ¿Puede el modelo completar la tarea?
- Coste: ¿Cuál es el coste combinado de ejecutar este modelo?
- Velocidad: ¿La latencia es lo suficientemente buena para la experiencia de usuario que quiero ofrecer?
El rendimiento ya es suficiente
Estaba felizmente programando hace un par de semanas, cuando se lanzó Opus 5 (pero para mi gran decepción, sin reiniciar los límites de la suscripción). Más tarde ese día, un amigo mío me preguntó cómo era. Lo había tenido quizás medio día en ese momento, en un trabajo bastante ordinario. Le dije que era bueno. Luego admití que no podía señalar nada de ese día en lo que Opus 5 se sintiera tan diferente de Sonnet 5.
No estoy diciendo que esto sea siempre así, pero cada vez más, siento que cómo uso el modelo marca mucha más diferencia que qué modelo uso. Hay tareas realmente difíciles en las que un modelo más inteligente realmente marca la diferencia, pero cada vez es menos frecuente.
Esto es básicamente el Dilema del Innovador en su máxima expresión: las empresas dominantes siguen mejorando aquello por lo que sus mejores clientes pagan, hasta que el producto es mejor de lo que la mayor parte del mercado necesita. En ese punto, la gente deja de pagar por más, y la competencia se traslada al precio y la velocidad. Les pasó a los discos duros. Creo que está empezando a pasarle a la inteligencia.
Estamos empezando a verlo con Kimi K3 (y los modelos chinos en general). Kimi es capaz de competir con Fable, siendo significativamente más barato.
Para mí, las cosas se pondrán realmente interesantes cuando empecemos a ver la inteligencia de Opus 5 a un coste combinado de $1/M.
¿Por qué $1/M? La cifra sale de un análisis de OpenRouter que compara los modelos y sus precios.
Primero consulté su API pública de modelos y calculé un coste combinado (asumiendo 3 tokens de entrada por cada token de salida) para los 253 modelos de los principales laboratorios. La mediana resultó ser de $1.00 por millón de tokens, justo en la línea.
Pero los precios de lista solo te dicen lo que hay en el menú, no lo que la gente pide. OpenRouter también publica datos de clasificación con el volumen real de tokens semanal por modelo. Uní las últimas 12 semanas de volumen a los precios actuales, y el resultado me sorprendió.
Esperaba que lo barato ganara. No lo hace, al menos no limpiamente. Los dos modelos más grandes por volumen son ultra baratos: DeepSeek V4 Flash y Xiaomi MiMo, ambos a $0.18/M. Pero Claude Opus 4.7, a $10/M, sigue siendo el número 6 por volumen, con Opus 4.8 y Sonnet 4.6 muy cerca. Los modelos que realmente pierden son los del medio. La categoría de $1-5/M obtiene el menor volumen de todos.
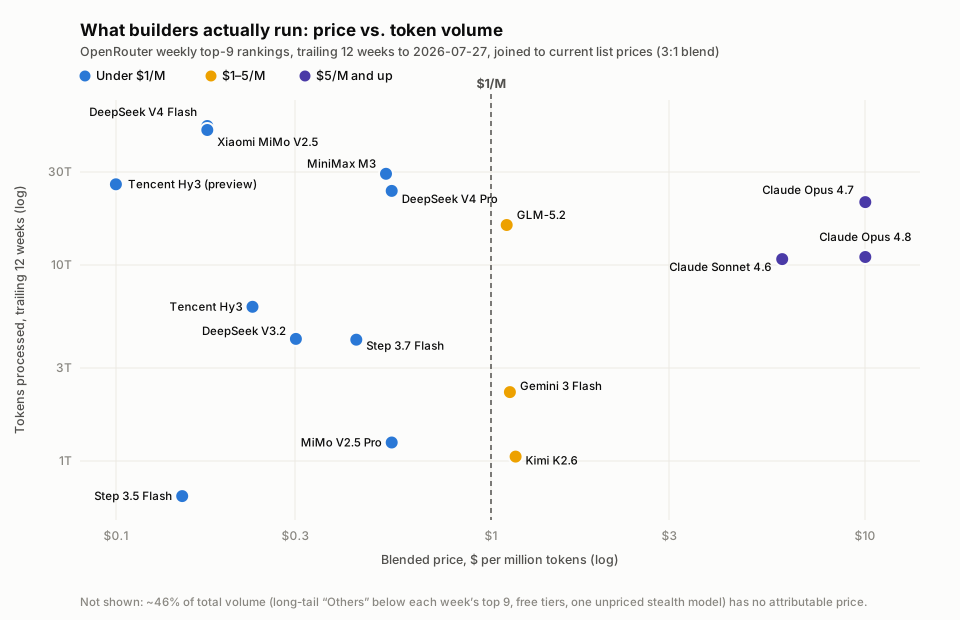
Abarrotado por debajo de $1/M, abarrotado de nuevo por encima de $5/M, casi vacío en el medio.
La frontera de la velocidad
Pero el precio no es el final de la historia. El Dilema del Innovador no solo se aplicará al precio, sino también a la velocidad. Cada vez que una dimensión supera lo que el mercado necesita, la competencia se traslada a la siguiente:
- Inteligencia: supera lo necesario para la mayoría de las tareas. Esta es la ola que está terminando.
- Precio: la ola en la que estamos ahora mismo. Eso es lo que muestra el gráfico anterior.
- Velocidad: la ola por la que todavía nadie compite en serio.
Hoy en día, la velocidad es cara. Entregar tokens más rápido a un usuario significa agrupar menos usuarios en el mismo hardware. SemiAnalysis midió esta relación entre velocidad y coste: generar aproximadamente 2.5 veces más rápido cuesta aproximadamente 7 veces más por token. Ahora mismo puedes tener rápido o puedes tener barato, pero no ambos.
Es exactamente por eso que creo que la velocidad viene en tercer lugar. Una vez que los modelos alcancen la frontera de $1/M, el precio será lo suficientemente bueno para muchas aplicaciones, de la misma manera que la inteligencia ya lo hizo para la mayoría de las tareas. Lo que rompa el compromiso entre velocidad y coste (mejor hardware, mejores sistemas de inferencia o sistemas de enrutamiento que solo van rápido donde importa) iniciará la próxima ola.
Y esa ola es la que más me entusiasma. Imagina si pudiéramos obtener latencia de milisegundos y 10k tokens/s en las respuestas de IA. Tanto nuestra capa de aplicación como nuestra capa de productividad cambiarían drásticamente. No más cambio de pestañas esperando que la IA complete su trabajo. Experiencias de usuario rápidas en la capa de aplicación. Y más velocidad literalmente significa más inteligencia, ya que podrías tener sistemas de agentes más complejos ejecutándose en el mismo tiempo.
Entonces, ¿qué tan lejos estamos de esto?
Honestamente, más cerca de lo que esperaba cuando empecé a escribir esto. Los mejores datos que tenemos dicen que el coste de un nivel fijo de inteligencia cae en algún lugar entre 10x por año (estimación de a16z) y 30-50x por año (la más reciente de Epoch AI). Incluso en el extremo lento de ese rango, la inteligencia de Opus 5 a un coste combinado de $1/M está aproximadamente a dos años de distancia. Y una vez que el precio deje de ser el diferenciador, espero que la guerra de la velocidad empiece de verdad.
En Vertical, este es básicamente el futuro para el que estoy construyendo. Intento no apostar por ningún modelo individual. Apuesto por la curva: cada pocos meses vuelvo a ejecutar las mismas evaluaciones, y un modelo más barato supera el listón para otra tarea. Si la frontera de $1/M llega a tiempo, la capa de aplicación dejará de racionar la inteligencia por completo, y los productos se diseñarán en función de lo que los usuarios necesitan en lugar de lo que cuestan los tokens.