En développant Vertical, j'ai beaucoup réfléchi à l'avenir de l'IA. Singularité, poids ouverts, intelligence de pointe. Dans cet article, je soutiens que le dilemme de l’innovateur va bientôt commencer à s'appliquer aux modèles actuels. Nous nous soucierons bientôt beaucoup plus du prix et de la vitesse que de l'intelligence brute.
Quand je pense à l'IA, il y a deux flux de travail qui sont importants pour moi. La productivité et l'application. Par productivité, j’entends toute l'IA que j'utilise pour moi-même et pour gérer Vertical. Pour le moment, ma productivité est fortement subventionnée par OpenAI et Anthropic, ce sont donc les principaux modèles que j'utilise. Par application, j'entends les modèles que j'utilise réellement pour fournir Vertical en tant que produit.
Choisir un modèle au niveau de l'application est beaucoup plus difficile que de choisir au niveau de la productivité. Le coût et la latence comptent beaucoup plus ici (malheureusement, OpenAI et Anthropic ne me subventionnent pas, et je finance moi-même l’entreprise, sans apport de fonds de capital-risque). Il y a trois facteurs :
- Performance du modèle : Le modèle peut-il accomplir la tâche ?
- Coût : Quel est le coût moyen pondéré d'exécution de ce modèle ?
- Vitesse : La latence est-elle assez faible pour l'expérience utilisateur que je souhaite offrir ?
Les performances sont déjà suffisantes
Je bidouillais joyeusement il y a quelques semaines, quand Opus 5 est sorti (mais à ma grande déception, sans réinitialisation d'abonnement). Plus tard ce jour-là, un de mes amis m'a demandé ce que ça donnait. Je l'avais depuis environ une demi-journée à ce moment-là, sur un travail assez ordinaire. Je lui ai dit que c'était bon. Puis j'ai admis que je ne pouvais citer aucune tâche de cette journée où Opus 5 se distinguait nettement de Sonnet 5.
Je ne dis pas que c'est toujours le cas, mais de plus en plus, je sens que comment j'utilise le modèle fait beaucoup plus de différence que quel modèle j'utilise. Il y a des tâches vraiment difficiles où un modèle plus intelligent fait réellement une différence, mais c'est de moins en moins fréquent.
C'est fondamentalement le dilemme de l’innovateur à son apogée : les acteurs établis continuent d'améliorer ce pour quoi leurs meilleurs clients paient, jusqu'à ce que le produit soit meilleur que ce dont la majeure partie du marché a besoin. À ce moment-là, les gens cessent de payer davantage pour cela, et la concurrence se déplace vers le prix et la vitesse. Cela est arrivé aux disques durs. Je pense que cela commence à arriver à l'intelligence.
Nous commençons à le voir avec Kimi K3 (et les modèles chinois plus généralement). Kimi peut rivaliser avec Fable, tout en étant significativement moins cher.
Pour moi, les choses deviendront vraiment intéressantes lorsque nous commencerons à voir l'intelligence d'Opus 5 au coût moyen pondéré de 1 $/M.
Pourquoi 1 $/M ? Eh bien, cela vient en fait d'une analyse d'OpenRouter des modèles par rapport à leurs prix.
J'ai d'abord extrait leur API de modèles publics et calculé un coût moyen pondéré (en supposant 3 tokens d'entrée pour chaque token de sortie) pour les 253 modèles des principaux laboratoires. La médiane s'est avérée être de 1,00 $ par million de tokens, se situant exactement sur la ligne.
Mais les prix affichés ne vous disent que ce qui est au menu, pas ce que les gens commandent. OpenRouter publie également des données de classement avec le volume hebdomadaire réel de tokens par modèle. J'ai joint les 12 dernières semaines de volume aux prix actuels, et le résultat m'a surpris.
Je m'attendais à ce que le pas cher gagne. Ce n'est pas le cas, du moins pas clairement. Les deux plus grands modèles en volume sont ultra-bon marché : DeepSeek V4 Flash et Xiaomi MiMo, tous deux à 0,18 $/M. Mais Claude Opus 4.7, à 10 $/M, est toujours le n°6 en volume, avec Opus 4.8 et Sonnet 4.6 juste derrière. Les modèles qui perdent réellement sont ceux du milieu. La catégorie 1-5 $/M obtient le moins de volume de tous.
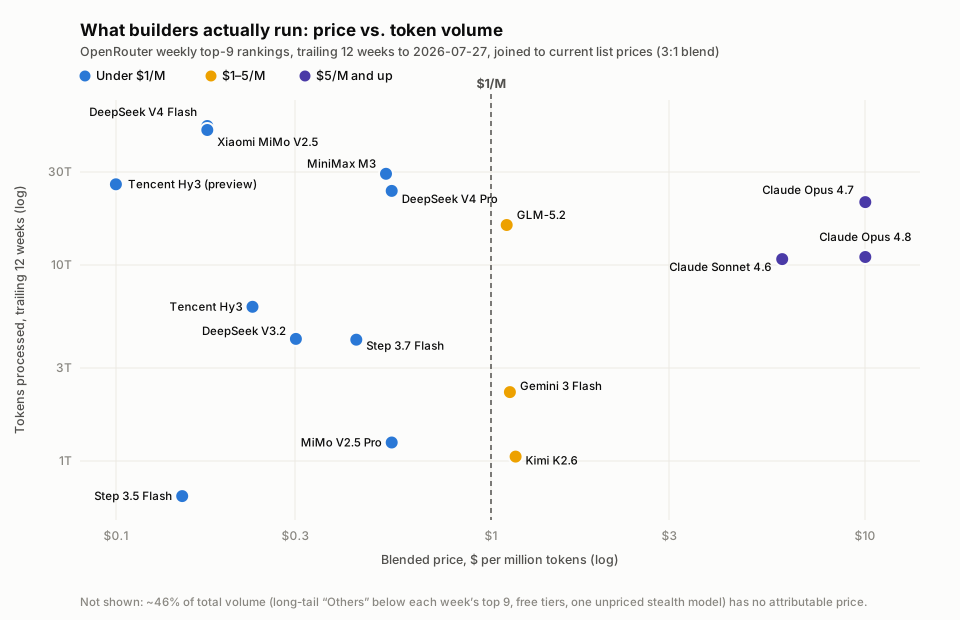
Beaucoup de modèles sous 1 $/M et au-dessus de 5 $/M, presque aucun entre les deux.
Le prochain seuil : la vitesse
Mais le prix n'est pas la fin de l'histoire. Le dilemme de l’innovateur ne s'appliquera pas seulement au prix, mais aussi à la vitesse. Dès que les performances sur un axe dépassent les besoins, la concurrence se déplace vers le suivant :
- Intelligence : supérieure aux besoins de la plupart des tâches. C'est la vague qui se termine.
- Prix : la vague dans laquelle nous sommes actuellement. C'est ce que montre le graphique ci-dessus.
- Vitesse : la vague sur laquelle personne ne se bat encore vraiment.
Aujourd'hui, la vitesse coûte cher. Servir des tokens plus rapidement à un utilisateur signifie regrouper moins d'utilisateurs sur le même matériel. SemiAnalysis a mesuré ce compromis : générer environ 2,5 fois plus vite coûte environ 7 fois plus par token. Actuellement, vous pouvez être rapide ou vous pouvez être bon marché, mais pas les deux.
C'est exactement pourquoi je pense que la vitesse vient en troisième. Une fois que les modèles atteindront la frontière de 1 $/M, le prix deviendra suffisamment bas pour de nombreuses applications, de la même manière que l'intelligence l'a déjà fait pour la plupart des tâches. Tout ce qui brisera le compromis vitesse-coût (meilleur matériel, meilleure distribution, ou des systèmes de routage qui ne vont vite que là où cela compte) lancera la prochaine vague.
Et cette vague est celle qui m'enthousiasme le plus. Imaginez si nous pouvions obtenir une latence de millisecondes et 10 000 tokens par seconde sur les réponses de l'IA. Cela transformerait nos applications et nos outils de productivité. Fini le passage d’un onglet à l’autre en attendant que l'IA termine son travail. Des expériences utilisateur rapides au niveau de l'application. Et plus de vitesse signifie littéralement plus d'intelligence, car vous pouvez exécuter des systèmes d'agents plus complexes dans le même temps.
À quelle échéance ?
Honnêtement, c’est plus proche que je ne le pensais en commençant à écrire ceci. Les meilleures données dont nous disposons indiquent que le coût d'un niveau d'intelligence fixe diminue quelque part entre un facteur 10 par an (estimation de a16z) et un facteur 30 à 50 par an (celle plus récente d'Epoch AI). Même à l'extrémité lente de cette fourchette, l'intelligence d'Opus 5 à 1 $/M en coût moyen pondéré est à environ deux ans. Et une fois que le prix cessera d'être le facteur de différenciation, je m'attends à ce que la guerre de la vitesse commence réellement.
Chez Vertical, c'est fondamentalement l'avenir pour lequel je construis. J'essaie de ne pas parier sur un seul modèle. Je parie sur la courbe : tous les quelques mois, je refais les mêmes évaluations, et un modèle moins cher franchit la barre pour une autre tâche. Si la frontière de 1 $/M arrive à temps, la couche applicative n’aura plus besoin de rationner l’intelligence, et les produits seront conçus en fonction de ce dont les utilisateurs ont besoin au lieu du coût des tokens.