Beim Aufbau von Vertical habe ich viel über die Zukunft der KI nachgedacht. Singularität, offene Modellgewichte, die leistungsfähigsten Modelle. In diesem Artikel argumentiere ich, dass das Innovator's Dilemma bald auf die aktuellen Modelle anwendbar sein wird. Wir werden uns bald viel mehr um Preis und Geschwindigkeit kümmern als um reine Intelligenz.
Wenn ich über KI nachdenke, gibt es zwei Arbeitsabläufe, die für mich wichtig sind. Produktivität und Anwendung. Mit Produktivität meine ich die gesamte KI, die ich für mich selbst und zum Betrieb von Vertical verwende. Im Moment wird meine Produktivität stark von OpenAI und Anthropic subventioniert, daher sind dies die primären Modelle, die ich verwende. Mit Anwendung meine ich die Modelle, die ich tatsächlich verwende, um Vertical als Produkt anzubieten.
Die Auswahl eines Modells auf der Anwendungsschicht ist viel schwieriger als die Auswahl auf der Produktivitätsschicht. Kosten und Latenz sind hier viel wichtiger (leider subventionieren mich OpenAI und Anthropic nicht, und ich bin bootstrapped, also auch keine VC-Subventionen). Es gibt drei Faktoren:
- Modellleistung: Kann das Modell die Aufgabe erledigen?
- Kosten: Was kostet der Betrieb dieses Modells bei einem Mix aus Eingabe- und Ausgabe-Token?
- Geschwindigkeit: Ist die Latenz gut genug für das Benutzererlebnis, das ich bieten möchte?
Leistung ist bereits gut genug
Ich war vor ein paar Wochen zufrieden am Programmieren, als Opus 5 herauskam (aber zu meiner großen Enttäuschung ohne Abonnement-Reset). Später an diesem Tag fragte mich ein Freund, wie es sei. Ich hatte es zu diesem Zeitpunkt vielleicht einen halben Tag lang für ziemlich gewöhnliche Arbeit benutzt. Ich sagte ihm, es sei gut. Dann gab ich zu, dass ich an diesem Tag nichts finden konnte, bei dem sich Opus 5 so anders anfühlte als Sonnet 5.
Ich sage nicht, dass das immer der Fall ist, aber immer öfter habe ich das Gefühl, dass wie ich das Modell verwende, einen viel größeren Unterschied macht als welches Modell ich verwende. Es gibt wirklich schwierige Aufgaben, bei denen ein intelligenteres Modell tatsächlich einen Unterschied macht, aber es wird immer seltener.
Dies ist im Grunde das Innovator's Dilemma in seiner reinsten Form: etablierte Unternehmen verbessern weiterhin das, wofür ihre besten Kunden bezahlen, bis das Produkt besser ist als das, was der Großteil des Marktes braucht. An diesem Punkt hören die Leute auf, mehr dafür zu bezahlen, und der Wettbewerb verlagert sich auf Preis und Geschwindigkeit. Es geschah mit Festplatten. Ich denke, es beginnt mit der Intelligenz zu geschehen.
Wir sehen es bereits bei Kimi K3 (und chinesischen Modellen im Allgemeinen). Kimi kann mit Fable konkurrieren und ist dabei deutlich günstiger.
Für mich wird es wirklich interessant, wenn wir die Leistungsfähigkeit von Opus 5 für 1 $ pro Million Token im Eingabe-Ausgabe-Mix sehen.
Warum $1/M? Nun, das stammt tatsächlich aus einer OpenRouter-Analyse der Modelle im Vergleich zu ihren Preisen.
Zuerst habe ich deren öffentliche Modelle-API abgerufen und die gemischten Kosten (unter der Annahme von 3 Eingabe-Token je Ausgabe-Token) für die 253 Modelle der großen Labore berechnet. Der Median lag bei 1,00 $ pro Million Token, genau auf der Linie.
Aber Listenpreise sagen nur, was auf der Speisekarte steht, nicht, was die Leute bestellen. OpenRouter veröffentlicht auch Ranking-Daten mit dem tatsächlichen wöchentlichen Token-Volumen pro Modell. Ich habe die letzten 12 Wochen des Volumens mit den aktuellen Preisen verknüpft, und das Ergebnis überraschte mich.
Ich erwartete, dass billig gewinnt. Das tut es nicht, zumindest nicht eindeutig. Die beiden größten Modelle nach Volumen sind extrem billig: DeepSeek V4 Flash und Xiaomi MiMo, beide zu 0,18 $/M. Aber Claude Opus 4.7, zu 10 $/M, ist immer noch die Nummer 6 nach Volumen, mit Opus 4.8 und Sonnet 4.6 dicht dahinter. Die Modelle, die tatsächlich verlieren, sind die in der Mitte. Die $1-5/M-Stufe erhält das geringste Volumen von allen.
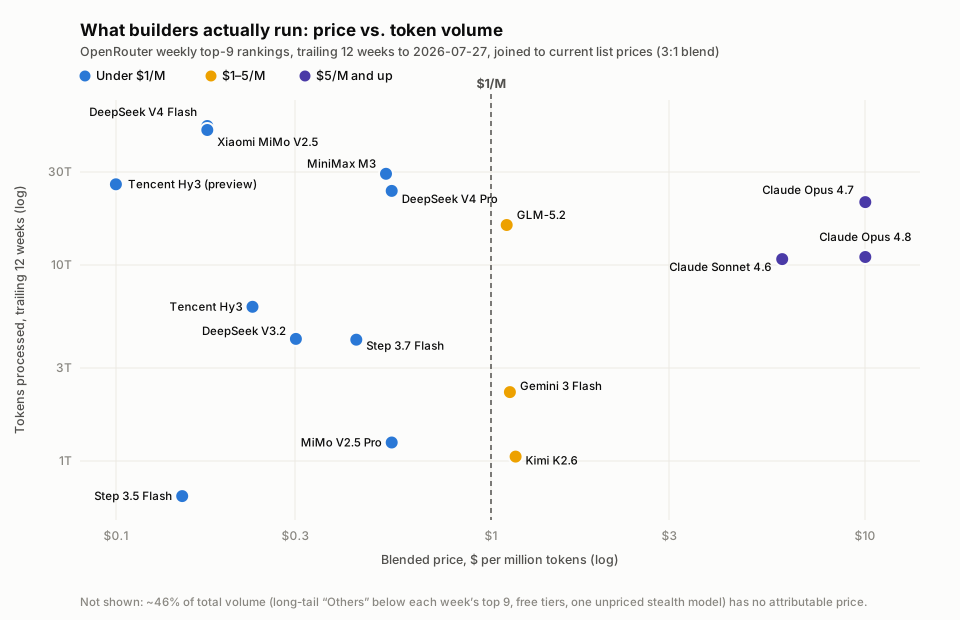
Dicht unter $1/M, wieder dicht über $5/M, dazwischen fast leer.
Die Geschwindigkeitsgrenze
Aber der Preis ist nicht das Ende der Geschichte. Das Innovator's Dilemma wird sich nicht nur auf den Preis, sondern auch auf die Geschwindigkeit beziehen. Sobald das Angebot in einem Bereich den tatsächlichen Bedarf übersteigt, verlagert sich der Wettbewerb auf den nächsten:
- Intelligenz: Für die meisten Aufgaben leistungsfähiger als nötig. Dies ist die Welle, die zu Ende geht.
- Preis: Die Welle, in der wir uns gerade befinden. Das zeigt die obige Grafik.
- Geschwindigkeit: Die Welle, in der noch niemand ernsthaft um die Spitze kämpft.
Heute ist Geschwindigkeit teuer. Token schneller an einen Benutzer auszugeben bedeutet, weniger Benutzer auf derselben Hardware zu bündeln. SemiAnalysis hat diesen Kompromiss gemessen: Eine etwa 2,5-mal schnellere Ausgabe kostet ungefähr 7-mal mehr pro Token. Im Moment kann man schnell oder billig haben, aber nicht beides.
Genau deshalb glaube ich, dass die Geschwindigkeit an dritter Stelle kommt. Sobald Modelle die $1/M-Grenze erreichen, wird der Preis für viele Anwendungen gut genug sein, so wie es die Intelligenz bereits für die meisten Aufgaben war. Was auch immer den Zielkonflikt zwischen Geschwindigkeit und Kosten auflöst (bessere Hardware, bessere Bereitstellung oder Routing-Systeme, die nur dort schnell sind, wo es darauf ankommt), startet die nächste Welle.
Und diese Welle ist die, auf die ich mich am meisten freue. Stell dir KI-Antworten mit Millisekunden Latenz und 10k Token pro Sekunde vor. Sowohl unsere Anwendungsschicht als auch unsere Produktivitätsschicht würden sich drastisch verändern. Kein lästiges Umschalten von Tabs mehr, während man darauf wartet, dass die KI ihre Arbeit beendet. Sofortige Antworten in unseren Anwendungen. Und mehr Geschwindigkeit bedeutet buchstäblich mehr Intelligenz, da man komplexere Agentensysteme in derselben Zeit ausführen kann.
Wie weit ist das entfernt?
Ehrlich gesagt, näher als ich erwartet hatte, als ich anfing, dies zu schreiben. Die besten Daten, die wir haben, besagen, dass die Kosten für ein festes Intelligenzniveau irgendwo zwischen 10x pro Jahr (Schätzung von a16z) und 30-50x pro Jahr (neuere Schätzung von Epoch AI) fallen. Selbst am langsamen Ende dieses Bereichs ist die Leistungsfähigkeit von Opus 5 zu gemischten Kosten von 1 $ pro Million Token etwa zwei Jahre entfernt. Und sobald der Preis aufhört, das Unterscheidungsmerkmal zu sein, erwarte ich, dass der Wettbewerb um Geschwindigkeit richtig beginnt.
Bei Vertical baue ich im Grunde für diese Zukunft. Ich versuche, nicht auf ein einzelnes Modell zu setzen. Ich setze auf die Kurve: Alle paar Monate führe ich dieselben Evaluierungen erneut durch, und ein günstigeres Modell erfüllt die Anforderungen für eine weitere Aufgabe. Wenn die $1/M-Grenze pünktlich erreicht wird, muss die Anwendungsschicht den Einsatz von KI-Leistung nicht mehr rationieren, und Produkte werden danach entwickelt, was Benutzer brauchen, anstatt danach, was Token kosten.