Mentre sto costruendo Vertical, ho riflettuto molto sul futuro dell'IA. Singolarità, modelli a pesi aperti, intelligenza di frontiera. In questo articolo, sostengo che il Dilemma dell'Innovatore inizierà presto ad applicarsi agli attuali modelli. Presto ci preoccuperemo molto di più del prezzo e della velocità che della pura intelligenza.
Quando penso all'IA, ci sono due flussi di lavoro importanti per me. Produttività e applicazione. Per produttività, intendo tutta l'IA che uso per me stesso e per gestire Vertical. Al momento, la mia produttività è fortemente sovvenzionata da OpenAI e Anthropic, quindi questi sono i modelli principali che uso. Per applicazione, intendo i modelli che uso effettivamente per fornire Vertical come prodotto.
Scegliere un modello a livello di applicazione è molto più difficile che scegliere a livello di produttività. Costo e latenza sono molto più importanti qui (sfortunatamente, OpenAI e Anthropic non mi sovvenzionano, e sono autofinanziato, quindi nemmeno sussidi VC). Ci sono tre fattori:
- Performance del modello: Il modello è in grado di completare il compito?
- Costo: Qual è il costo medio ponderato di esecuzione di questo modello?
- Velocità: La latenza è sufficientemente buona per l'esperienza utente che voglio offrire?
La performance è già abbastanza buona
Stavo lavorando al codice un paio di settimane fa, quando Opus 5 è uscito (ma con mia grande delusione, senza un ripristino dei limiti del mio abbonamento). Più tardi quel giorno, un mio amico mi ha chiesto com'era. L'avevo avuto per forse mezza giornata a quel punto, su un lavoro piuttosto ordinario. Gli dissi che era buono. Poi ammisi che non riuscivo a indicare nulla di quel giorno in cui Opus 5 sembrasse così diverso da Sonnet 5.
Non sto dicendo che sia sempre così, ma sempre di più, sento che come uso il modello fa molta più differenza di quale modello uso. Ci sono compiti veramente difficili in cui un modello più intelligente fa davvero la differenza, ma sta diventando sempre meno frequente.
Questo è in pratica il Dilemma dell'Innovatore nella sua forma classica: le aziende affermate continuano a migliorare ciò per cui i loro migliori clienti pagano, finché il prodotto non è migliore di ciò di cui la maggior parte del mercato ha bisogno. A quel punto le persone smettono di pagarne di più, e la competizione si sposta su prezzo e velocità. È successo ai dischi rigidi. Penso che stia iniziando a succedere all'intelligenza.
Stiamo iniziando a vederlo con Kimi K3 (e i modelli cinesi più in generale). Kimi è in grado di competere con Fable, pur essendo significativamente più economico.
Per me, le cose diventeranno davvero interessanti quando inizieremo a vedere l'intelligenza di Opus 5 al costo medio ponderato di $1/M.
Perché $1/M? Bene, questo deriva da un'analisi di OpenRouter sui modelli rispetto ai loro prezzi.
Per prima cosa ho estratto la loro API pubblica dei modelli e ho calcolato un costo medio ponderato (supponendo 3 token di input per ogni token di output) per i 253 modelli dei principali laboratori. La mediana è risultata di $1.00 per milione di token, esattamente sulla linea.
Ma i prezzi di listino ti dicono solo cosa c'è nel menu, non cosa le persone ordinano. OpenRouter pubblica anche dati di classifica con il volume settimanale effettivo di token per modello. Ho unito le ultime 12 settimane di volume ai prezzi attuali, e il risultato mi ha sorpreso.
Mi aspettavo che il prezzo basso vincesse. Non è così, almeno non in modo netto. I due modelli più grandi per volume sono ultra economici: DeepSeek V4 Flash e Xiaomi MiMo, entrambi a $0.18/M. Ma Claude Opus 4.7, a $10/M, è ancora il 6° per volume, con Opus 4.8 e Sonnet 4.6 subito dietro. I modelli che effettivamente perdono sono quelli intermedi. La fascia di $1-5/M ottiene il minor volume di tutti.
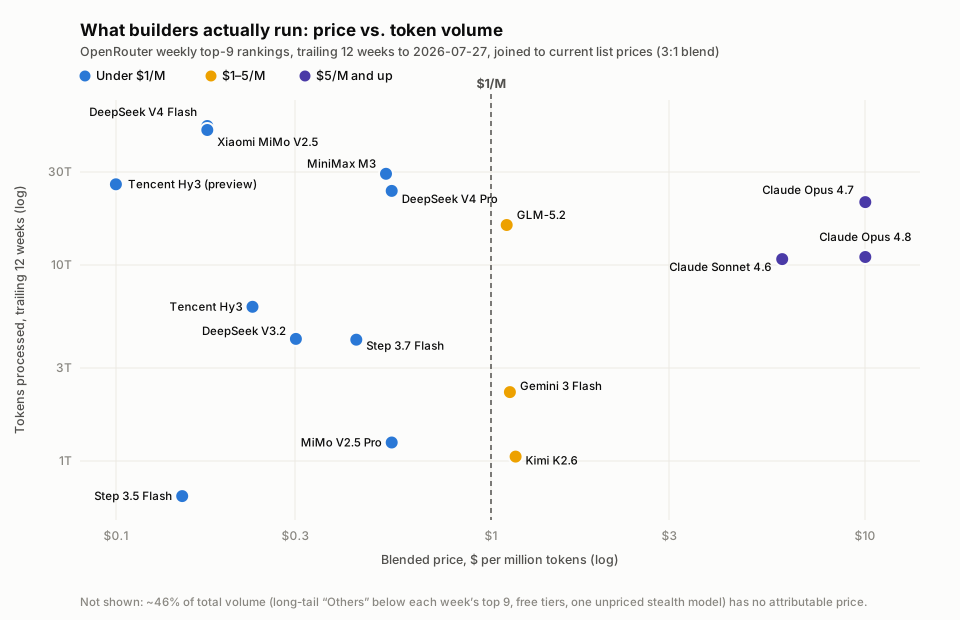
Affollato sotto $1/M, di nuovo affollato sopra $5/M, quasi vuoto nel mezzo.
La frontiera della velocità
Ma il prezzo non è la fine della storia. Il Dilemma dell'Innovatore non si applicherà solo al prezzo, ma anche alla velocità. Ogni volta che le prestazioni su un parametro superano le esigenze del mercato, la competizione si sposta sul successivo:
- Intelligenza: già superiore alle esigenze della maggior parte dei compiti. Questa è l'onda che sta finendo.
- Prezzo: l'onda in cui ci troviamo adesso. Questo è ciò che mostra il grafico sopra.
- Velocità: l'onda che nessuno sta ancora seriamente combattendo.
Oggi, la velocità è costosa. Servire i token più velocemente a un utente significa raggruppare meno utenti sullo stesso hardware. SemiAnalysis ha misurato questo compromesso: generare circa 2.5 volte più velocemente costa circa 7 volte di più per token. Attualmente si può avere velocità o si può avere economicità, ma non entrambe.
Ecco perché penso che la velocità venga al terzo posto. Una volta che i modelli raggiungeranno la frontiera di $1/M, il prezzo diventerà sufficientemente buono per molte applicazioni, allo stesso modo in cui l'intelligenza lo è già per la maggior parte dei compiti. Qualsiasi cosa rompa il compromesso velocità-costo (hardware migliore, sistemi di inferenza migliori o sistemi di routing che vanno veloci solo dove conta) darà il via alla prossima onda.
E quell'onda è quella che mi entusiasma di più. Immagina se potessimo ottenere una latenza di millisecondi e 10k/s token nelle risposte IA. Sia il nostro livello di applicazione che il livello di produttività cambierebbero drasticamente. Niente più cambi di scheda in attesa che l'IA completi il suo lavoro. Esperienze utente veloci a livello di applicazione. E più velocità significa letteralmente più intelligenza, poiché si è in grado di far funzionare sistemi di agenti più complessi nello stesso tempo.
Quindi, quanto è lontana questa realtà?
Onestamente, più vicina di quanto mi aspettassi quando ho iniziato a scrivere questo. I migliori dati che abbiamo dicono che il costo di un livello fisso di intelligenza diminuisce da 10 volte all'anno (stima di a16z) a 30-50 volte all'anno (quella più recente di Epoch AI). Anche all'estremità più lenta di questo intervallo, l'intelligenza di Opus 5 con un costo medio ponderato di $1/M è a circa due anni di distanza. E una volta che il prezzo smetterà di essere il differenziatore, mi aspetto che la guerra della velocità inizi seriamente.
In Vertical, questo è fondamentalmente il futuro per cui sto costruendo. Cerco di non scommettere su un singolo modello. Scommetto sulla curva: ogni pochi mesi eseguo di nuovo le stesse valutazioni, e un modello più economico supera l'asticella per un altro compito. Se la frontiera di $1/M arriva in tempo, il livello dell'applicazione smette di razionare completamente l'intelligenza, e i prodotti vengono progettati in base alle esigenze degli utenti invece che al costo dei token.